前缀函数理论
前缀函数描述一个字符串的各个前缀内部,前缀与后缀怎样重合。
一、问题原型
给定一个长度为 n 的字符串 s,对于每个位置 i,考虑前缀 s[0…i]。
我们希望知道,这个前缀的开头和结尾,最多有多少字符完全相同。
前后缀与 Border
对于长度为 n 的字符串 s,长度为 k 的前缀是:s[0…k−1],后缀是:s[n−k…n−1],除开本身整个字符串以外的前后缀,都属于 真前后缀。
如果一个字符串同时是 s 的真前缀和真后缀,就称它是 s 的一个 Border。
比如 s = "ababa",它的非空 Border 有 a | aba,其中最长的 Border 的长度为 3。
笔记
Border 只要求前缀与后缀相等,允许二者在原字符串中重叠。
前缀函数
于是可以得到前缀函数 π 的定义,π[i] 表示 s[0…i] 的最长 Border 长度。
也就是说,π[i]=k 表示 s[0…k−1]=s[i−k+1…i]。
并且不存在更大的合法 k。
特别地,规定 π[0]=0,因为长度为 1 的字符串不存在非空真前后缀。
前缀函数与
nxt
本文统一使用 pi[i] 表示前缀 s[0...i] 的最长 Border 长度。
传统 KMP 教材中的 next / nxt 定义并不统一:有时与 pi 完全相同,有时表示失配后的匹配状态,还可能存在一位偏移或 -1 哨兵。
二、如何计算前缀函数
根据定义,可以从长到短枚举每个前缀的 Border 长度。
1
2
3
4
5
6
7
8
9
| int n = s.length( );
for( int i = 1; i < n; ++ i ) {
for( int j = i; j >= 0; -- j ) {
if( s.substr(0, j) == s.substr(i - j + 1, j) ) {
pi[i] = j;
break;
}
}
}
|
对于位置 i,候选 Border 长度为:i,i−1,…,0,每次还需要比较两个长度为 O(n) 的子串,因此最坏时间复杂度为 O(n3),但具有很大的改进空间。
优化1
观察相邻前缀函数值之间的关系。
若长度为 π[i] 的 Border 能继续向右扩展,则 π[i+1]=π[i]+1,否则前缀函数值只能保持不变或减小。
因此 π[i+1]≤π[i]+1,我们每次只需要从 π[i−1]+1 开始枚举向下检查就行。
1
2
3
4
5
6
7
8
9
| int n = s.length( );
for( int i = 1; i < n; ++ i ) {
for( int j = pi[i-1] + 1; j >= 0; -- j ) {
if( s.substr(0, j) == s.substr(i - j + 1, j) ) {
pi[i] = j;
break;
}
}
}
|
计算 π[i] 时,候选长度的枚举次数为:π[i−1]+2−π[i],对所有位置求和:
i=1∑n−1(π[i−1]+2−π[i])=2n−2−π[n−1]=O(n)
所以再乘上每次比较两个长度最多为 O(n) 的子串,复杂度为 O(n2),发现还能优化,这次考虑从子串比较的代价入手。
优化2
为了配合下图,先讨论如何从 π[i] 推出 π[i+1]。
我们已经知道,当 s[i+1]=s[π[i]] 时,当前最长 Border 可以继续扩展,因此:π[i+1]=π[i]+1。
接下来考虑 s[i+1]=s[π[i]] 的情况。
此时,长度为 π[i] 的最长 Border 无法继续扩展,我们希望找到小于 π[i] 的最大合法 Border 长度 j,再尝试比较 s[i+1] 和 s[j]。
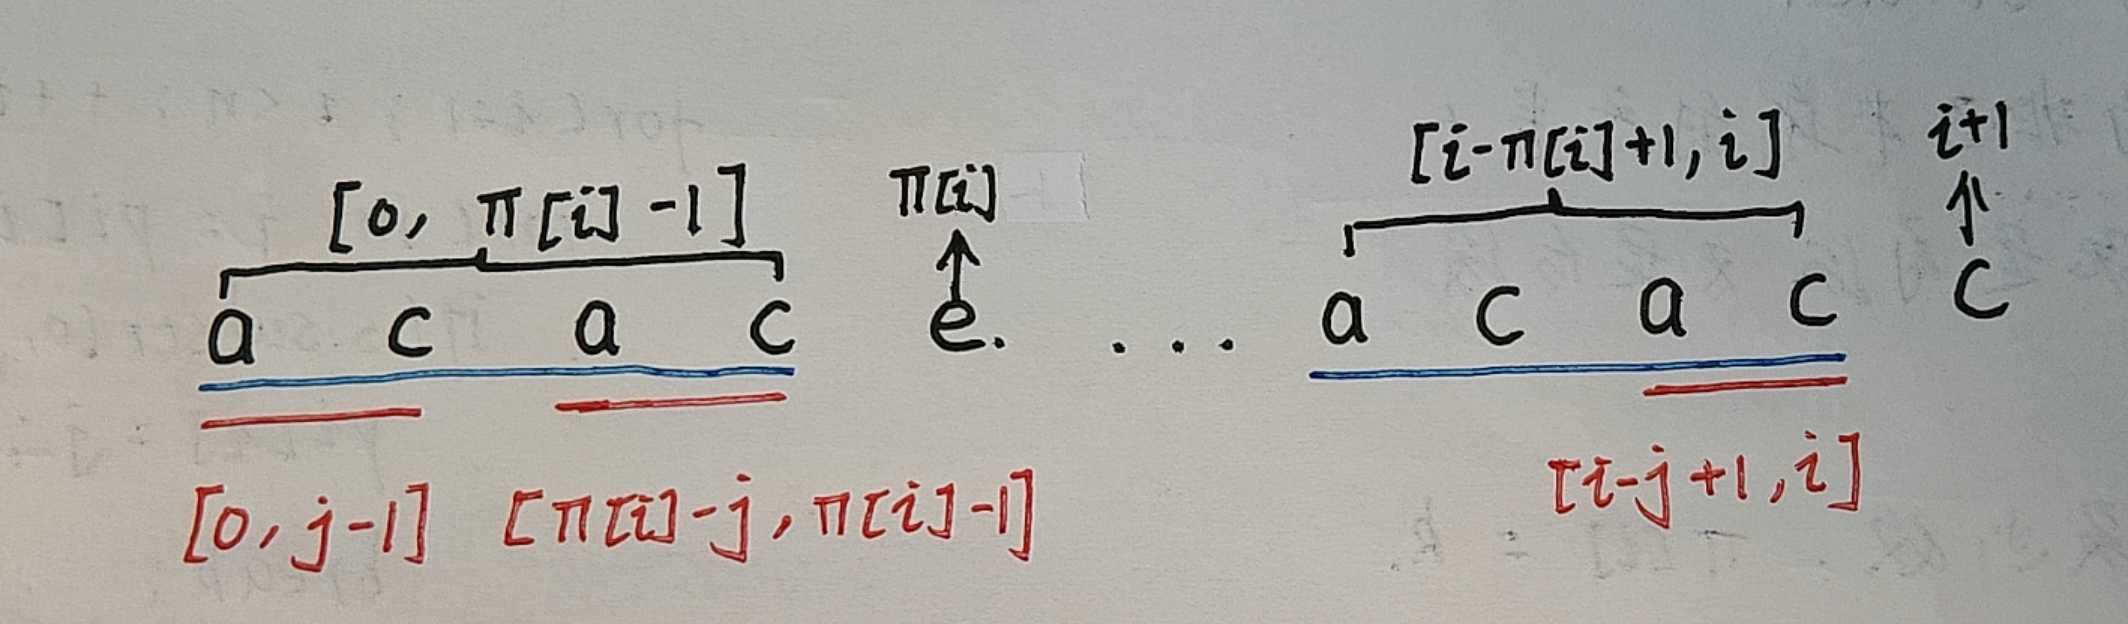
如图,长度为 j 的候选满足 s[0…j−1]=s[i−j+1…i],而长度为 π[i] 的最长 Border 满足:s[0…π[i]−1]=s[i−π[i]+1…i](黑标)。
由于长度为 j 的后缀完全位于 π[i] 的后缀内部,所以 s[0…j−1]=s[π[i]−j…π[i]−1](红标)。
也就是说,长度为 j 的字符串同时是 s[0…π[i]−1] 的真前缀和真后缀,也就是这个前缀的 Border。
所以小于 π[i] 的最大合法候选长度就是 j=π[π[i]−1],如果 s[i+1]=s[j],就接着寻找 j 的最长 Border:j←π[j−1]。
因此,所有可能的候选长度构成:π[i], π[π[i]−1], π[π[π[i]−1]−1], …, 0,这条链我们就称之为当前前缀的 Border 链。
于是可以得到前缀函数的线性递推,代码也意外地简单。下面的代码只是把上面的 i+1 整体平移为当前处理位置 i。
1
2
3
4
5
6
7
8
9
| void build( const string &s ) {
int m = (int)s.size( );
pi[0] = 0;
for( int i = 1, j = 0; i < m; ++ i ) {
while( j && s[i] != s[j] ) j = pi[j - 1];
if( s[i] == s[j] ) ++ j;
pi[i] = j;
}
}
|
虽然存在两重循环,但每次匹配成功,j 才会增加 1;而 j 的总增加次数不超过 n−1,它的总减少次数也不会超过此前累计的增加量。
所以,while 的执行次数之和为 O(n),构建前缀函数的时间复杂度也就为 O(n)。
三、Border 链与失配树
对于每个前缀,它的所有 Border 长度都会沿前缀函数形成一条 Border 链。那么,把所有前缀的 Border 链放在一起,又会形成怎样的结构呢?
把每一个前缀长度看作一个节点 0,1,2,…,n,其中节点 L 表示长度为 L 的前缀 s[0…L−1]。
对于每个 L≥1,我们令它的父亲为 fa(L)=π[L−1]。由于 π[L−1]<L,所以每个非根节点都有唯一父亲,并且沿父亲不断跳转,最终一定会到达 0。
这些节点与父边形成的一颗以 0 为根的树,就成为 失配树。
在失配树中:
- 一个前缀的最长 Border 是它的父亲;
- 所有非空 Border 是它的非零真祖先;
- Border 链就是该节点到根的路径;
- KMP 中的失配回退,就是不断向父亲移动。
因此,前缀函数虽然只记录每个前缀的最长 Border,却通过父指针隐式保存了它的全部 Border。
四、周期
Border 还可以直接描述字符串的周期结构。
对于长度为 n 的字符串 s,如果一个正整数 p 满足:s[i]=s[i−p],其中 p≤i<n,那么我们称 p 是字符串 s 的一个 周期。
假设字符串存在一个长度为 b 的 Border,则 s[0…b−1]=s[n−b…n−1],这两个相等子串的起点相差 p=n−b。
于是对于所有满足 p≤i<n 的位置,都有 s[i]=s[i−p],所以 p=n−b 是字符串的一个周期。
反之,如果 p 是字符串的一个周期,那么 s[0…n−p−1]=s[p…n−1]。因此,长度为 n−p 的字符串是原串的 Border。
所以长度为 b 的 Border 与 长度为 n−b 的周期一一对应。
当前长度为 n 的字符串的最短周期:n−π[n−1],与最长 Border 对应。
周期与循环节
周期只要求满足 s[i]=s[i−p],不要求 p 整除 n。
例如 cabcabca 的最短周期是 3,但它并不是由 cab 完整重复若干次得到的。
如果题目要求整个字符串由某个字符串完整重复构成,还需要满足:nmodp=0。
若不满足,则这个周期不能作为完整循环节。
具体的周期、循环节与 Border 题型参见 前缀函数题型整理。
五、模式匹配
前缀函数首先描述的是一个字符串自身的 Border 结构。
接下来考虑模式匹配问题:给定模式串 p 和文本串 t,寻找 p 在 t 中的所有出现位置。
笔记
文本串 t:被搜索的字符串;
模式串 p:希望在文本串中寻找的字符串。
设文本串长度为 n,模式串长度为 m。
我们希望寻找所有的位置 i,满足 t[i…i+m−1]=p[0…m−1]。
在扫描文本串 t[i] 之前,定义 j 为当前已经匹配的模式串前缀长度,也就是说,当前已处理的文本的某个后缀满足 t[i−j…i−1]=p[0…j−1]。
接下来就只需要比较 t[i] 与 p[j],如果相等,那么匹配长度增加 j←j+1。
否则如果失配,我们考虑沿着模式串的 Border 链回退。
当 j=m 时,说明当前整个模式串已经完成匹配,匹配的起点为 i−m+1。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
|
vector<int> kmp( const string &T, const string &P ) {
int n = (int)T.size( ), m = (int)P.size( );
vector<int> pos;
build( P );
for( int i = 0, j = 0; i < n; ++ i ) {
while( j && T[i] != P[j] ) j = pi[j - 1];
if( T[i] == P[j] ) ++ j;
if( j == m ) {
pos.push_back( i - m + 1 );
j = pi[j - 1];
}
}
return pos;
}
|
由于文本串下标 i 始终向右移动,只有模式串的匹配状态 j 沿 Border 链回退。
所以,构建模式串前缀函数 O(m),扫描文本串 O(n),总复杂度为 O(n+m)。
六、前缀自动机
普通 KMP 每处理一个新字符 ch,都会执行:
1
2
| while( j && ch != P[j] ) j = pi[j - 1];
if( ch == P[j] ) ++ j;
|
这一结果只取决于:当前匹配状态 j,以及新读入的字符 ch。
因此可以定义状态转移 go[j][ch],表示当前已经匹配模式串前 j 个字符,再读入字符 ch 后,新的最长匹配前缀长度。
对于长度为 m 的模式串,共有 m+1 个状态 0,1,2,…,m,状态 m 表示完整匹配了模式串。
普通 KMP 需要沿着 π 链现场计算转移,前缀自动机则通过预处理提前计算所有转移,扫描时可以直接查表完成状态转移。
当然,它不会改善普通模式匹配的渐进复杂度,但它的意义在于把字符串匹配转化为标准的有限状态转移,从而和其他算法结合,比如 DP。
示例
- 统计长度为 n 且不包含某个模式串的字符串数量;
- 统计模式串恰好出现若干次的字符串数量;
- 在图上行走时同步维护匹配状态;
- 处理无法显式展开的超长字符串;
- 将状态转移写成矩阵并快速幂;
- 对同一个模式串处理大量文本。
前缀自动机 与 AC 自动机
单个模式串的所有前缀形成一条链,前缀自动机的状态就在这条链上。
多个模式串的所有前缀形成一棵 Trie,AC 自动机则在 Trie 上建立失配指针。
单模式串前缀链 + π → KMP 前缀自动机。
多模式串前缀 Trie + fail → AC 自动机。
它们之间的关系是:当 AC 自动机中只有一个模式串时,Trie 退化为一条链,fail 指针也就退化为前缀函数表示的 Border 跳转。
七、信息边界与其他问题
前缀函数保存:
- 每个前缀的最长 Border;
- 通过父指针隐式保存的完整 Border 链;
- 前缀之间的失配关系;
- 单模式串匹配所需的状态回退信息。
它没有直接保存:
- 每个 Border 的全部出现位置;
- 任意两个子串的相等关系;
- 任意两个后缀的最长公共前缀;
- 回文结构;
- 多个模式串之间的分支关系;
- 所有子串的扩展与出现集合。
因此,若问题研究:
- 多模式串匹配,通常需要 [[AC自动机]];
- 回文结构,通常需要 [[Manacher]];
- 任意子串比较,可能需要 [[字符串哈希]];
- 所有后缀的字典序,通常需要 [[后缀数组]];
- 所有子串的扩展和出现集合,可能需要 [[后缀自动机]]。
八、代码实现
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
|
namespace KMP {
int pi[maxn];
void build( const string &s ) {
    int m = (int)s.size( );
    pi[0] = 0;
    for( int i = 1, j = 0; i < m; ++ i ) {
        while( j && s[i] != s[j] ) j = pi[j - 1];
        if( s[i] == s[j] ) ++ j;
        pi[i] = j;
    }
}
vector<int> kmp( const string &T, const string &P ) {
int n = (int)T.size( ), m = (int)P.size( );
vector<int> pos;
build( P );
for( int i = 0, j = 0; i < n; ++ i ) {
while( j && T[i] != P[j] ) j = pi[j - 1];
if( T[i] == P[j] ) ++ j;
if( j == m ) {
pos.push_back( i - m + 1 );
j = pi[j - 1];
}
}
return pos;
}
}
|